ᱥᱴᱮᱴᱤᱥᱴᱤᱠᱟᱞ ᱜᱚᱱᱚᱝ
“ᱜᱚᱱᱚᱝ” ᱢᱮᱱᱮᱛ ᱫᱚ ᱴᱷᱤᱠ ᱪᱟᱠᱟ ᱨᱮ ᱟᱹᱰᱤ ᱠᱚᱢ ᱦᱩᱭ ᱫᱟᱲᱮᱭᱟᱜ, “ᱥᱟᱹᱨᱤ” ᱫᱚ ᱵᱟᱝ ᱟᱨ “ᱞᱟᱵᱷ” ᱦᱚᱸ ᱵᱟᱝ᱾
0.05 ᱨᱮᱭᱟᱜ p ᱜᱚᱱᱚᱝ ᱢᱮᱱᱮᱛ ᱫᱚ ᱴᱷᱤᱠ ᱪᱟᱠᱟ ᱦᱚᱸ ᱢᱤᱫ ᱤᱥᱤ ᱫᱷᱟᱣ ᱨᱮ ᱢᱤᱫ ᱫᱷᱟᱣ ᱱᱚᱶᱟ ᱞᱮᱠᱟᱱ ᱵᱮᱵᱷᱟᱨ ᱦᱚᱨᱟ ᱩᱫᱩᱜᱟ᱾ ᱡᱩᱫᱤ ᱟᱯᱮ ᱢᱤᱫ ᱤᱥᱤ ᱪᱟᱠᱟ ᱧᱮᱞ ᱯᱮ, ᱢᱤᱫᱴᱟᱹᱝ ᱫᱚ ᱵᱷᱟᱜᱽ ᱛᱮ ᱯᱟᱥ ᱦᱩᱭᱩᱜ-ᱟ᱾
p ᱜᱚᱱᱚᱝ ᱫᱚ ᱪᱮᱫ ᱠᱟᱱᱟ
Assuming the stated null model, the p-valueᱞᱮᱵp ᱜᱚᱱᱚᱝᱪᱟᱠᱟ ᱴᱷᱤᱠ ᱛᱟᱦᱮᱸ ᱠᱷᱟᱱ, ᱧᱮᱞ ᱟᱠᱟᱱ ᱟᱞᱟᱜ ᱥᱟᱶ ᱥᱚᱢᱟᱱ ᱟᱨᱵᱟᱝ ᱢᱟᱨᱟᱝ ᱟᱞᱟᱜ ᱧᱮᱞ ᱨᱮᱭᱟᱜ ᱥᱚᱢᱵᱷᱟᱵᱱᱟ᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ → is the probabilityᱜᱚᱱᱤᱛᱥᱚᱢᱵᱷᱟᱵᱱᱟᱢᱤᱫ ᱨᱮᱡᱟᱞᱴ ᱨᱮᱭᱟᱜ ᱥᱚᱢᱵᱷᱟᱵᱱᱟ, 0 ᱠᱷᱚᱱ 1 ᱟᱨᱵᱟᱝ 0% ᱠᱷᱚᱱ 100%᱾ ᱢᱤᱫ ᱮᱞ: 1/37 = 2.70%᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ → of a test statistic at least as extreme as the observed one. It is not the probability that the wheel is fair or that the result arose by chance. Interpretation also depends on the design, assumptions and tests attempted.
ᱟᱭᱢᱟ ᱢᱮᱞ
ᱴᱷᱤᱠ ᱪᱟᱠᱟ ᱨᱮ ᱟᱯᱮ ᱡᱟᱦᱟᱸ ᱜᱮ ᱯᱚᱨᱚᱠᱷ ᱪᱟᱞᱟᱣ ᱯᱮ, ᱚᱱᱟ ᱫᱚ 5% ᱥᱚᱛᱚᱨ ᱨᱮ ᱯᱟᱥ ᱦᱩᱭ ᱨᱮᱭᱟᱜ 5% ᱥᱚᱢᱵᱷᱟᱵᱱᱟ ᱢᱮᱱᱟᱜ-ᱟ᱾ ᱢᱤᱫ ᱤᱥᱤ ᱪᱟᱠᱟ ᱯᱚᱨᱚᱠᱷ ᱯᱮ, ᱢᱤᱫᱴᱟᱹᱝ ᱯᱟᱥ ᱦᱩᱭᱩᱜ-ᱟ᱾ ᱢᱤᱫ ᱪᱟᱠᱟ ᱢᱤᱫ ᱤᱥᱤ ᱚᱠᱛᱚ ᱦᱤᱥᱟᱹ ᱨᱮ ᱯᱚᱨᱚᱠᱷ ᱯᱮ, ᱢᱤᱫᱴᱟᱹᱝ ᱯᱟᱥ ᱦᱩᱭᱩᱜ-ᱟ᱾ ᱢᱤᱫ ᱱᱢᱩᱱᱟ 37 ᱠᱷᱟᱱᱟᱥᱟᱡ ᱥᱟᱢᱟᱱᱠᱷᱟᱱᱟᱨᱚᱴᱚᱨ ᱨᱮᱭᱟᱜ 37 ᱮᱞ ᱚᱞ ᱠᱷᱟᱱᱟ ᱠᱷᱚᱱ ᱢᱤᱫ᱾ ᱮᱴᱟᱜ ᱧᱩᱛᱩᱢ: ᱥᱞᱚᱴ, ᱠᱟᱯ᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ → ᱜᱟᱫᱮᱞ, ᱛᱩᱨᱩᱭ ᱥᱮᱠᱴᱚᱨᱪᱟᱠᱟᱥᱮᱠᱴᱚᱨᱪᱟᱠᱟ ᱨᱮ ᱛᱟᱭᱚᱢ ᱛᱟᱭᱚᱢ ᱠᱷᱟᱱᱟ ᱨᱮᱭᱟᱜ ᱢᱤᱫ ᱜᱩᱞᱟᱹᱭ ᱦᱟᱹᱴᱤᱧ, ᱞᱮᱭᱟᱣᱴ ᱨᱮᱭᱟᱜ ᱜᱩᱴᱤ ᱠᱷᱚᱱ ᱟᱞᱟᱜ᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ → ᱜᱟᱫᱮᱞ ᱟᱨ ᱯᱮ ᱨᱚᱝ ᱜᱟᱫᱮᱞ ᱥᱟᱶ ᱯᱚᱨᱚᱠᱷ ᱯᱮ, ᱟᱨ ᱡᱟᱦᱟᱸ ᱜᱮ ᱯᱟᱥ ᱦᱩᱭᱩᱜ-ᱟ᱾ ᱥᱟᱯᱲᱟᱣ ᱫᱚ ᱱᱚᱶᱟ ᱠᱟᱱᱟ: ᱰᱟᱴᱟ ᱧᱮᱞ ᱞᱟᱦᱟ ᱨᱮ ᱯᱚᱨᱚᱠᱷ ᱴᱷᱤᱠ ᱯᱮ, ᱢᱤᱫ ᱫᱷᱟᱣ ᱪᱟᱞᱟᱣ ᱯᱮ, ᱟᱨ ᱱᱟᱣᱟ ᱰᱟᱴᱟ ᱨᱮ ᱥᱟᱵᱩᱫ ᱯᱮ᱾ ᱡᱟᱦᱟᱸ ᱧᱮᱞ ᱛᱮ “ᱵᱟᱭᱟᱥ” ᱪᱟᱠᱟ ᱧᱟᱢᱚᱜ-ᱟ, ᱚᱱᱟ ᱧᱮᱞ ᱜᱮ ᱟᱹᱰᱤ ᱦᱚᱨ ᱢᱩᱪᱟᱹᱫ ᱵᱮᱱᱟᱣᱟ᱾
ᱜᱚᱱᱚᱝ ᱟᱨ ᱢᱟᱯ
A large sample can detect a small departure from fairness that still does not make a bet profitable. At a true pocket probability of 1/36.5, a 35:1 bet has negative expectation. At 1/36 it breaks even. A p-value does not measure the size or practical value of an effect.
ᱫᱟᱲᱮ
Power is the chance of rejecting the null under a specified alternative. For one pocket chosen in advance, an exact one-sided 5% binomial test on 1,000 spins rejects at 37 or more hits. If the true rate is 1/30, its power is about 28%, not 50%.
ᱢᱤᱫ ᱠᱟᱹᱢᱤ ᱨᱮᱭᱟᱜ ᱥᱚᱛᱚᱨ
ᱢᱤᱫ ᱵᱟᱭᱟᱥ ᱫᱟᱵᱤ ᱧᱮᱞ ᱞᱟᱹᱠᱛᱤ ᱦᱩᱭ ᱞᱟᱹᱜᱤᱫ: ᱟᱜᱟᱢ ᱨᱮ ᱵᱟᱪᱷᱟᱣ ᱟᱠᱟᱱ ᱯᱚᱨᱚᱠᱷ, 0.05 ᱵᱚᱫᱚᱞ p < 0.01, ᱢᱤᱫ ᱞᱮᱠᱟᱱ ᱢᱟᱯ ᱨᱮᱭᱟᱜ ᱟᱡᱟᱫ ᱱᱢᱩᱱᱟ ᱨᱮ ᱫᱚᱦᱲᱟ ᱠᱚᱨᱟᱣ, ᱟᱨ ᱫᱚᱦᱲᱟ ᱠᱚᱨᱟᱣ ᱛᱟᱭᱚᱢ ᱵᱟᱹᱲᱛᱤ ᱛᱷᱤᱨ ᱠᱷᱟᱱᱟ ᱨᱮ 1/34 ᱟᱨᱵᱟᱝ ᱚᱱᱟ ᱠᱷᱚᱱ ᱵᱮᱥ ᱟᱸᱫᱟᱡᱽ ᱛᱷᱤᱨ ᱦᱟᱨ᱾ ᱠᱷᱮᱞ ᱨᱮᱭᱟᱜ ᱤᱛᱤᱦᱟᱹᱥ ᱨᱮ ᱱᱚᱶᱟ ᱥᱚᱛᱚᱨ ᱫᱚ ᱮᱞᱠᱷᱟᱹ ᱦᱩᱰᱤᱧ ᱥᱮᱞᱮᱫ ᱫᱷᱟᱣ ᱯᱩᱨᱟᱹᱣ ᱟᱠᱟᱱᱟ, ᱟᱨ ᱥᱟᱱᱟᱢ ᱦᱚᱲ ᱵᱟᱰᱟᱭ ᱞᱮᱠᱷᱟ ᱞᱮᱠᱟᱛᱮ, ᱥᱟᱯᱲᱟᱣ ᱟᱠᱟᱱ ᱱᱟᱣᱟ ᱪᱟᱠᱟ ᱨᱮ ᱫᱚ ᱛᱤᱥ ᱦᱚᱸ ᱵᱟᱝ᱾
ᱠᱩᱠᱞᱤ ᱠᱚ
1920 ᱥᱮᱨᱢᱟ ᱠᱚ ᱠᱷᱚᱱ ᱨᱤᱱᱤᱡ᱾ ᱚᱱᱟ ᱨᱮ ᱪᱮᱫ ᱦᱚᱸ ᱟᱞᱜᱟ ᱵᱟᱹᱱᱩᱜ-ᱟ; ᱟᱭᱢᱟ ᱪᱟᱠᱟ ᱧᱮᱞ ᱚᱠᱛᱚ 0.01 ᱫᱚ ᱵᱟᱹᱲᱛᱤ ᱵᱩᱫᱽᱫᱷᱤ ᱥᱟᱶ ᱥᱤᱢᱟᱹ ᱠᱟᱱᱟ᱾
ᱦᱩᱭ ᱫᱟᱲᱮᱭᱟᱜ-ᱟ ᱥᱚᱢᱟᱱ ᱢᱩᱪᱟᱹᱫ ᱵᱟᱝ ᱮᱢ ᱮᱫᱟ᱾ ᱚᱱᱟ ᱫᱚ ᱰᱤᱞᱟᱨ ᱦᱚᱨᱚᱥ, ᱚᱞ ᱵᱷᱩᱞ ᱟᱨᱵᱟᱝ ᱰᱟᱴᱟ ᱟᱫᱮᱨ ᱥᱚᱢᱥᱭᱟ ᱦᱚᱸ ᱦᱩᱭ ᱫᱟᱲᱮᱭᱟᱜ-ᱟ᱾ ᱫᱚᱦᱲᱟ ᱠᱚᱨᱟᱣ ᱯᱮ᱾
No. That requires a separate estimate of hit probability, its uncertainty and the actual payoutᱴᱟᱠᱟᱵᱷᱩᱜᱛᱟᱱᱡᱤᱛ ᱵᱟᱡᱤ ᱪᱮᱫ ᱨᱩᱣᱟᱹᱲᱟ, ᱨᱩᱣᱟᱹᱲ ᱵᱟᱡᱤ ᱴᱟᱠᱟ ᱪᱮᱛᱟᱱ “X ᱨᱮ 1” ᱞᱮᱠᱟ ᱨᱚᱲᱚᱜ-ᱟ᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ →.
ᱜᱚᱱᱤᱛ ᱥᱟᱶ ᱨᱟᱹᱥᱠᱟᱹ
ᱱᱚᱶᱟ ᱠᱚ ᱯᱩᱭᱞᱩ ᱟᱯᱮ ᱛᱮ ᱠᱩᱨᱩᱢᱩᱴᱩ ᱯᱮ᱾ ᱢᱤᱫ ᱢᱤᱫ ᱥᱚᱢᱟᱫᱷᱟᱱ ᱫᱚ ᱩᱠᱩ ᱢᱮᱱᱟᱜ-ᱟ; ᱛᱮᱭᱟᱨ ᱦᱩᱭ ᱠᱟᱛᱮ ᱡᱷᱤᱡᱽ ᱯᱮ᱾
Suppose a dozenᱵᱟᱡᱤᱰᱚᱡᱮᱱ1–12, 13–24 ᱟᱨᱵᱟᱝ 25–36, ᱵᱷᱩᱜᱛᱟᱱ 2:1᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ → chosen before data collection appears 742 times in 3,000 independent double-zeroᱪᱟᱠᱟᱡᱤᱨᱚᱢᱤᱫᱜᱮ ᱦᱟᱹᱨᱭᱟᱹᱲ ᱠᱷᱟᱱᱟ ᱡᱟᱦᱟᱸ ᱥᱚᱢᱟᱱ ᱴᱟᱠᱟ, ᱰᱚᱡᱮᱱ ᱟᱨᱵᱟᱝ ᱠᱚᱞᱚᱢ ᱵᱟᱡᱤ ᱵᱟᱭ ᱠᱚᱵᱷᱟᱨᱟ; ᱠᱮᱥᱤᱱᱳ ᱵᱟᱲᱛᱤ ᱨᱮᱭᱟᱜ ᱢᱩᱞ᱾ ᱮᱴᱟᱜ ᱧᱩᱛᱩᱢ: ᱥᱤᱝᱜᱚᱞ ᱡᱤᱨᱚ, 0᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ → spins. Under the uniform model, how many standard deviationsᱜᱚᱱᱤᱛᱥᱴᱮᱱᱰᱟᱨᱰ ᱰᱤᱵᱷᱤᱭᱮᱥᱚᱱᱣᱮᱨᱤᱭᱮᱱᱥ ᱨᱮᱭᱟᱜ ᱵᱚᱜᱚ ᱢᱩᱞ; ᱟᱸᱫᱟᱡᱽ ᱜᱚᱱᱚᱝ ᱠᱷᱚᱱ ᱨᱮᱡᱟᱞᱴ ᱨᱮᱭᱟᱜ ᱥᱟᱫᱷᱟᱨᱚᱱ ᱥᱟᱦᱟ᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ → below the mean is that? What is the probabilityᱜᱚᱱᱤᱛᱥᱚᱢᱵᱷᱟᱵᱱᱟᱢᱤᱫ ᱨᱮᱡᱟᱞᱴ ᱨᱮᱭᱟᱜ ᱥᱚᱢᱵᱷᱟᱵᱱᱟ, 0 ᱠᱷᱚᱱ 1 ᱟᱨᱵᱟᱝ 0% ᱠᱷᱚᱱ 100%᱾ ᱢᱤᱫ ᱮᱞ: 1/37 = 2.70%᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ → of 742 or fewer hits?
ᱥᱚᱢᱟᱫᱷᱟᱱ ᱩᱫᱩᱜ
ᱛᱮᱞᱟ ᱡᱟᱦᱟᱱ 8.1 ᱥᱴᱮᱱᱰᱟᱨᱰ ᱰᱤᱵᱷᱤᱭᱮᱥᱚᱱ ᱞᱟᱛᱟᱨ᱾ ᱴᱷᱤᱠ ᱪᱟᱠᱟ ᱚᱱᱟ ᱡᱟᱦᱟᱱ 3 × 10¹⁵ ᱠᱩᱨᱩᱢᱩᱴᱩ ᱨᱮ ᱢᱤᱫ ᱫᱷᱟᱣ ᱮ ᱵᱮᱱᱟᱣᱟ, ᱚᱱᱟ ᱫᱚ ᱛᱤᱥ ᱦᱚᱸ ᱵᱟᱝ᱾ ᱥᱚᱣᱟᱞ ᱥᱟᱶ ᱪᱷᱟᱯᱟ ᱩᱛᱛᱚᱨ 11.75 ᱮ ᱢᱮᱱᱟ; ᱟᱞᱮ 8.07 ᱞᱮ ᱧᱟᱢᱟ᱾
Under the stated model, X is binomial with n = 3,000 and p = 12/38. Its mean is np ≈ 947.37 and its standard deviation is √(np(1 − p)) ≈ 25.46.
The standardized difference is (742 − 947.37)/25.46 ≈ −8.07. Summing the exact binomial probabilities from 0 through 742 gives P(X ≤ 742) ≈ 9.77 × 10⁻¹⁷. A normal approximation with continuity correction gives about 4.25 × 10⁻¹⁶; the relative error is large this far into the tail.
This is the probability of the specified data event under the model, not the probability that the wheel is fair. Such a result calls for checking the observations, independence, uniformity and analysis plan. Selecting the worst-looking dozen after inspecting data, or searching many wheels or time periods, requires accounting for that selection.
ᱞᱟᱸᱫᱟ ᱞᱟᱹᱜᱤᱫ ᱠᱚᱢᱤᱠ
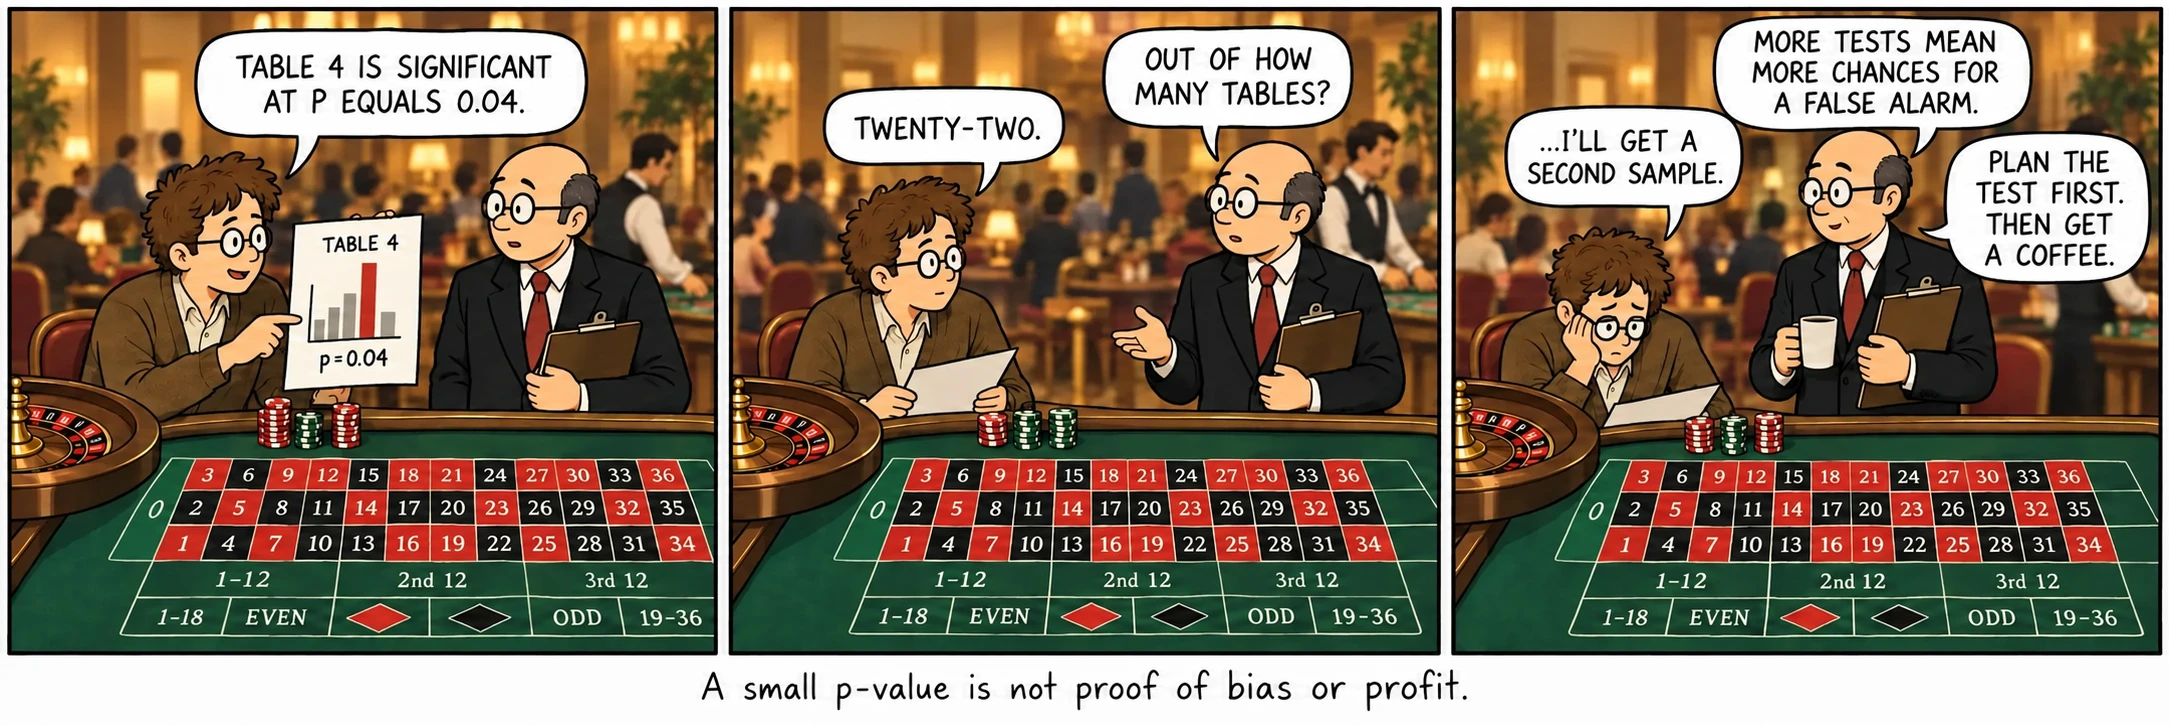
ᱢᱤᱫ ᱤᱥᱤ ᱴᱷᱤᱠ ᱪᱟᱠᱟ ᱨᱮ ᱢᱤᱫᱴᱟᱹᱝ “ᱜᱚᱱᱚᱝ” ᱜᱮᱭᱟ᱾ ᱮᱞ ᱨᱮᱭᱟᱜ ᱢᱮᱱᱮᱛ ᱫᱚ ᱱᱚᱶᱟ ᱜᱮ ᱠᱟᱱᱟ᱾
ᱯᱷᱮᱰᱟᱛ
- Pearson, K. “On the criterion that a given system of deviations from the probable…”
- Feller, W. An Introduction to Probability Theory and Its Applications, Vol. 1.