ᱨᱩᱞᱮᱴ ᱪᱟᱠᱟ ᱵᱟᱭᱟᱥ ᱪᱮᱫ ᱞᱮᱠᱟ ᱧᱟᱢ ᱦᱩᱭᱩᱜ-ᱟ
ᱚᱞ, ᱞᱮᱠᱷᱟ, ᱯᱚᱨᱚᱠᱷ, ᱛᱟᱭᱚᱢ ᱟᱨᱦᱚᱸ ᱚᱞ: ᱱᱚᱶᱟ ᱦᱚᱨ ᱛᱮ ᱨᱩᱞᱮᱴ ᱪᱟᱠᱟ ᱵᱟᱭᱟᱥ ᱧᱟᱢᱚᱜ-ᱟ᱾
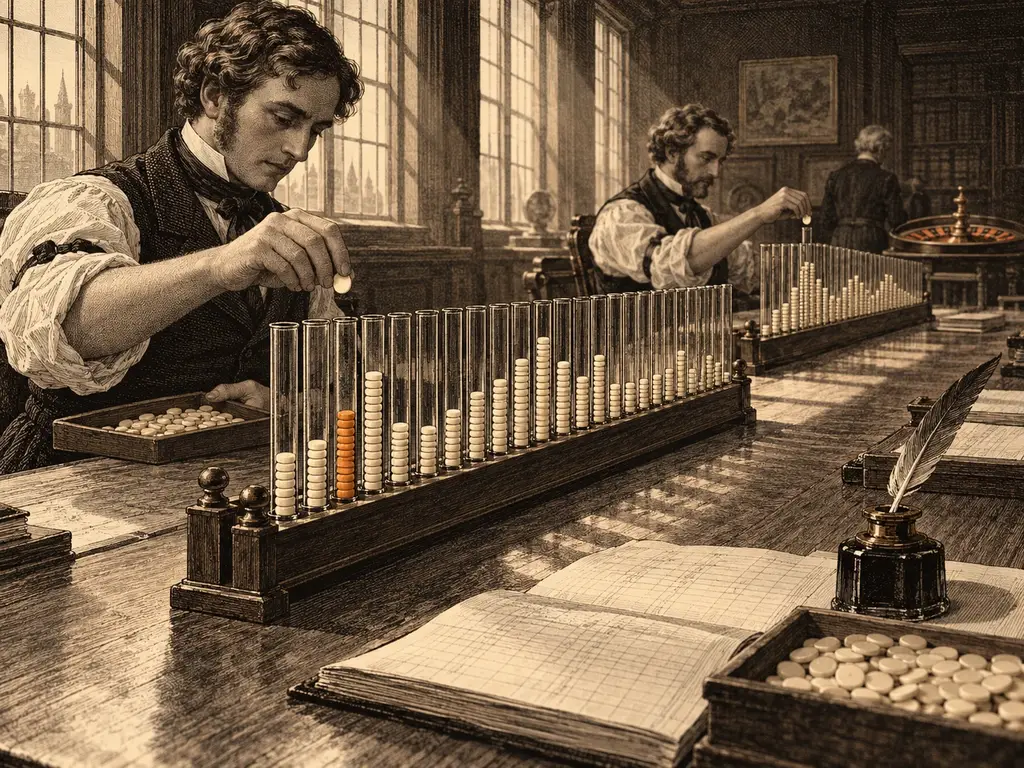
Use a reliable record from one identified wheel, choose the test before inspecting results, and confirm any finding with independent data. Sample size depends on the effect you want to detect.
1. ᱚᱞ
Record every outcome from one identified wheel, with dates and any known equipment changes. Missing rounds and changes of wheel can distort the analysis. There is no universal 1,000-spin minimum: validity and power depend on the test and the effect being studied.
2. ᱞᱮᱠᱷᱟ ᱟᱨ ᱯᱚᱨᱚᱠᱷ
For a fair single-zeroᱪᱟᱠᱟᱡᱤᱨᱚᱢᱤᱫᱜᱮ ᱦᱟᱹᱨᱭᱟᱹᱲ ᱠᱷᱟᱱᱟ ᱡᱟᱦᱟᱸ ᱥᱚᱢᱟᱱ ᱴᱟᱠᱟ, ᱰᱚᱡᱮᱱ ᱟᱨᱵᱟᱝ ᱠᱚᱞᱚᱢ ᱵᱟᱡᱤ ᱵᱟᱭ ᱠᱚᱵᱷᱟᱨᱟ; ᱠᱮᱥᱤᱱᱳ ᱵᱟᱲᱛᱤ ᱨᱮᱭᱟᱜ ᱢᱩᱞ᱾ ᱮᱴᱟᱜ ᱧᱩᱛᱩᱢ: ᱥᱤᱝᱜᱚᱞ ᱡᱤᱨᱚ, 0᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ → wheel, expected hits are n/37 per pocketᱥᱟᱡ ᱥᱟᱢᱟᱱᱠᱷᱟᱱᱟᱨᱚᱴᱚᱨ ᱨᱮᱭᱟᱜ 37 ᱮᱞ ᱚᱞ ᱠᱷᱟᱱᱟ ᱠᱷᱚᱱ ᱢᱤᱫ᱾ ᱮᱴᱟᱜ ᱧᱩᱛᱩᱢ: ᱥᱞᱚᱴ, ᱠᱟᱯ᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ →. Sum (observed − expected)² / expected across all 37 pockets. Under independent uniform spins, compare the result with an approximate chi-square distribution on 36 degrees of freedomᱞᱮᱵᱥᱟᱫᱷᱤᱱᱛᱟ ᱰᱤᱜᱽᱨᱤᱢᱤᱫ ᱥᱴᱮᱴᱤᱥᱴᱤᱠ ᱨᱮ ᱟᱡᱟᱫ ᱜᱚᱱᱚᱝ ᱨᱮᱭᱟᱜ ᱮᱞ᱾ 37 ᱠᱷᱟᱱᱟ ᱨᱮ ᱠᱟᱭ-ᱥᱠᱣᱮᱭᱟᱨ ᱯᱚᱨᱚᱠᱷ ᱞᱟᱹᱜᱤᱫ ᱱᱚᱶᱟ 36, ᱪᱮᱫᱟᱜ ᱥᱮ ᱞᱮᱠᱷᱟ ᱠᱚ ᱡᱚᱛᱚ ᱡᱚᱲᱟᱣ ᱦᱩᱭᱩᱜ ᱞᱟᱹᱠᱛᱤᱭᱟ᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ →. Choose any extra pocket or sectorᱪᱟᱠᱟᱥᱮᱠᱴᱚᱨᱪᱟᱠᱟ ᱨᱮ ᱛᱟᱭᱚᱢ ᱛᱟᱭᱚᱢ ᱠᱷᱟᱱᱟ ᱨᱮᱭᱟᱜ ᱢᱤᱫ ᱜᱩᱞᱟᱹᱭ ᱦᱟᱹᱴᱤᱧ, ᱞᱮᱭᱟᱣᱴ ᱨᱮᱭᱟᱜ ᱜᱩᱴᱤ ᱠᱷᱚᱱ ᱟᱞᱟᱜ᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ → tests in advance.
3. ᱫᱚᱦᱲᱟ ᱠᱚᱨᱟᱣ
A second independent sample checks whether the finding persists. Real effects can fail to reach significance again, and chance findings can recur. If you splitᱵᱟᱡᱤᱥᱯᱞᱤᱴᱵᱟᱨ ᱥᱟᱵᱟᱫ ᱮᱞ, ᱵᱷᱩᱜᱛᱟᱱ 17:1᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ → a record, keep the confirmation half unseen while choosing the hypothesis on the first half. Account for all tests tried.
4. ᱦᱚᱨᱚᱥ ᱨᱮᱭᱟᱜ ᱢᱟᱯ
On a 35:1 straight-up payoutᱴᱟᱠᱟᱵᱷᱩᱜᱛᱟᱱᱡᱤᱛ ᱵᱟᱡᱤ ᱪᱮᱫ ᱨᱩᱣᱟᱹᱲᱟ, ᱨᱩᱣᱟᱹᱲ ᱵᱟᱡᱤ ᱴᱟᱠᱟ ᱪᱮᱛᱟᱱ “X ᱨᱮ 1” ᱞᱮᱠᱟ ᱨᱚᱲᱚᱜ-ᱟ᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ →, expected net return per unitᱴᱟᱠᱟᱭᱩᱱᱤᱴᱢᱤᱫ ᱥᱤᱥᱴᱮᱢ ᱟᱨᱵᱟᱝ ᱠᱷᱮᱞᱚᱸᱰ ᱵᱮᱵᱷᱟᱨ ᱵᱮᱥ ᱵᱟᱡᱤ ᱴᱟᱠᱟ᱾ ᱯᱨᱚᱜᱽᱨᱮᱥᱚᱱ ᱠᱚ ᱭᱩᱱᱤᱴ ᱛᱮ ᱵᱩᱡᱷᱟᱹᱣᱚᱜ-ᱟ ᱡᱮᱢᱚᱱ ᱡᱟᱦᱟᱸᱱ ᱴᱮᱵᱩᱞ ᱨᱮ ᱞᱟᱹᱜᱩ ᱦᱩᱭᱩᱜ-ᱟ᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ → is 36p − 1. A true hit probabilityᱜᱚᱱᱤᱛᱥᱚᱢᱵᱷᱟᱵᱱᱟᱢᱤᱫ ᱨᱮᱡᱟᱞᱴ ᱨᱮᱭᱟᱜ ᱥᱚᱢᱵᱷᱟᱵᱱᱟ, 0 ᱠᱷᱚᱱ 1 ᱟᱨᱵᱟᱝ 0% ᱠᱷᱚᱱ 100%᱾ ᱢᱤᱫ ᱮᱞ: 1/37 = 2.70%᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ → of 1/36 breaks even; profitability requires more. An observed rate is an estimate with uncertainty, especially if you chose the hottest pocket after seeing the data.
ᱛᱟᱭᱚᱢ ᱪᱮᱫ: ᱱᱟᱣᱟ ᱠᱮᱥᱤᱱᱳ ᱨᱮ ᱨᱩᱞᱮᱴ ᱪᱟᱠᱟ ᱵᱟᱭᱟᱥ ᱧᱟᱢ
A statistical finding alone does not identify its physical cause or guarantee that the pattern will persist. Recording errors, changing equipment and changing operating conditions need investigation. Historical examples are covered separately; no maintenance schedule guarantees that every possible bias is detected first.
ᱥᱚᱵᱟᱹᱧ ᱵᱟᱹᱲᱛᱤ ᱛᱷᱤᱨ ᱠᱷᱟᱱᱟ ᱫᱚ ᱥᱟᱵᱮᱫ ᱢᱮᱱᱟᱜ-ᱟ
ᱥᱚᱵᱟᱹᱧ ᱵᱟᱹᱲᱛᱤ ᱛᱷᱤᱨ ᱠᱷᱟᱱᱟ ᱵᱟᱪᱷᱟᱣ ᱠᱟᱛᱮ ᱮᱞᱠᱷᱟᱹ ᱚᱱᱟ ᱯᱚᱨᱚᱠᱷ ᱫᱚ ᱢᱤᱫ ᱡᱟᱞ ᱠᱟᱱᱟ, ᱪᱮᱫᱟᱜ ᱥᱮ ᱴᱷᱤᱠ ᱪᱟᱠᱟ ᱨᱮ ᱦᱚᱸ ᱥᱟᱵᱮᱫ ᱢᱤᱫ ᱥᱚᱵᱟᱹᱧ ᱵᱟᱹᱲᱛᱤ ᱛᱷᱤᱨ ᱠᱷᱟᱱᱟ ᱢᱮᱱᱟᱜ-ᱟ᱾ 3,700 ᱜᱷᱩᱨᱟᱹᱣ ᱛᱟᱭᱚᱢ ᱡᱚᱛᱚ ᱠᱷᱟᱱᱟ ᱨᱮ 100 ᱛᱷᱤᱨ ᱟᱸᱫᱟᱡᱽ ᱢᱮᱱᱟᱜ-ᱟ, ᱢᱮᱱᱠᱷᱟᱱ ᱥᱚᱵᱟᱹᱧ ᱵᱟᱹᱲᱛᱤ ᱛᱷᱤᱨ ᱠᱷᱟᱱᱟ ᱥᱟᱫᱷᱟᱨᱚᱬ ᱛᱮ ᱯᱟᱥᱤ 122 ᱩᱫᱩᱜᱟ, ᱟᱨ ᱢᱤᱫ ᱤᱥᱤ ᱨᱮ ᱢᱤᱫ ᱱᱢᱩᱱᱟ ᱨᱮ 131 ᱟᱨᱵᱟᱝ ᱵᱟᱹᱲᱛᱤ᱾ ᱥᱚᱵᱟᱹᱧ ᱠᱚᱢ ᱛᱷᱤᱨ ᱠᱷᱟᱱᱟ ᱥᱟᱫᱷᱟᱨᱚᱬ ᱛᱮ ᱯᱟᱥᱤ 79 ᱩᱫᱩᱜᱟ᱾ ᱚᱱᱟᱛᱮ 3,700 ᱜᱷᱩᱨᱟᱹᱣ ᱨᱮ 125 ᱛᱷᱤᱨ ᱠᱷᱟᱱᱟ ᱫᱚ ᱢᱤᱫ ᱧᱟᱢ ᱫᱚ ᱵᱟᱝ: ᱚᱱᱟ ᱫᱚ ᱴᱷᱤᱠ ᱪᱟᱠᱟ ᱨᱮᱭᱟᱜ ᱥᱚᱵᱟᱹᱧ ᱵᱟᱹᱲᱛᱤ ᱛᱷᱤᱨ ᱠᱷᱟᱱᱟ ᱥᱟᱶ ᱢᱮᱞ ᱯᱮ, 100 ᱥᱟᱶ ᱫᱚ ᱵᱟᱝ᱾
ᱥᱟᱫᱷᱟᱨᱚᱬ ᱵᱷᱩᱞ ᱠᱚ
Do not pool unidentified wheels and interpret the result as a diagnosis of one wheel. Do not choose a sector after seeing the data without accounting for that search. Uniform marginal counts also do not establish independence: a process can have dependence without an obvious pocket-frequency imbalance.
ᱠᱩᱠᱞᱤ ᱠᱚ
ᱯᱚᱨᱚᱠᱷ ᱪᱟᱞᱟᱣ ᱞᱟᱹᱜᱤᱫ 1,000; ᱧᱟᱢ ᱞᱟᱹᱠᱛᱤ ᱵᱟᱭᱟᱥ ᱧᱟᱢ ᱞᱟᱹᱜᱤᱫ ᱟᱭᱢᱟ ᱦᱟᱡᱟᱨ; ᱥᱟᱵᱩᱫ ᱞᱟᱹᱜᱤᱫ ᱜᱮᱞ ᱜᱮᱞ ᱦᱟᱡᱟᱨ᱾
ᱮᱞᱠᱷᱟᱹ ᱡᱩᱫᱤ ᱚᱱᱟ ᱪᱟᱠᱟ ᱪᱤᱱᱦᱟᱹᱣ ᱮᱫᱟ ᱟᱨ ᱡᱚᱛᱚᱫ ᱜᱷᱩᱨᱟᱹᱣ ᱩᱫᱩᱜ ᱮᱫᱟ᱾ ᱟᱹᱰᱤ ᱵᱟᱹᱲᱛᱤ ᱵᱳᱨᱰ ᱫᱚ 20 ᱠᱷᱚᱱ 500 ᱩᱫᱩᱜᱟ, ᱡᱟᱦᱟᱸ ᱫᱚ ᱵᱟᱝ ᱥᱮᱴᱮᱨᱚᱜ-ᱟ᱾
ᱪᱟᱠᱟ ᱫᱚ ᱦᱩᱭ ᱫᱟᱲᱮᱭᱟᱜ-ᱟ ᱥᱚᱢᱟᱱ ᱢᱩᱪᱟᱹᱫ ᱵᱟᱝ ᱮᱢ ᱮᱫᱟ᱾ ᱡᱟᱦᱟᱸ ᱠᱷᱟᱱᱟ ᱥᱮᱴᱮᱨ ᱵᱷᱩᱜᱛᱟᱱ ᱮᱢᱟ ᱚᱱᱟ ᱫᱚ ᱵᱟᱝ, ᱟᱨ ᱚᱱᱟ ᱦᱚᱨᱟ ᱛᱟᱦᱮᱸᱱᱟ ᱚᱱᱟ ᱦᱚᱸ ᱵᱟᱝ᱾
ᱜᱚᱱᱤᱛ ᱥᱟᱶ ᱨᱟᱹᱥᱠᱟᱹ
ᱱᱚᱶᱟ ᱠᱚ ᱯᱩᱭᱞᱩ ᱟᱯᱮ ᱛᱮ ᱠᱩᱨᱩᱢᱩᱴᱩ ᱯᱮ᱾ ᱢᱤᱫ ᱢᱤᱫ ᱥᱚᱢᱟᱫᱷᱟᱱ ᱫᱚ ᱩᱠᱩ ᱢᱮᱱᱟᱜ-ᱟ; ᱛᱮᱭᱟᱨ ᱦᱩᱭ ᱠᱟᱛᱮ ᱡᱷᱤᱡᱽ ᱯᱮ᱾
Consider a hypothetical outcome distribution with probabilityᱜᱚᱱᱤᱛᱥᱚᱢᱵᱷᱟᱵᱱᱟᱢᱤᱫ ᱨᱮᱡᱟᱞᱴ ᱨᱮᱭᱟᱜ ᱥᱚᱢᱵᱷᱟᱵᱱᱟ, 0 ᱠᱷᱚᱱ 1 ᱟᱨᱵᱟᱝ 0% ᱠᱷᱚᱱ 100%᱾ ᱢᱤᱫ ᱮᱞ: 1/37 = 2.70%᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ → 15/37 for redᱵᱟᱡᱤᱟᱨᱟᱜ18 ᱟᱨᱟᱜ ᱮᱞ ᱨᱮ ᱥᱚᱢᱟᱱ ᱴᱟᱠᱟ ᱵᱟᱡᱤ᱾ ᱯᱷᱨᱮᱧᱪ ᱨᱮ: ᱨᱩᱡᱽ᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ →, 21/37 for blackᱵᱟᱡᱤᱦᱮᱸᱫᱮ18 ᱦᱮᱸᱫᱮ ᱮᱞ ᱨᱮ ᱥᱚᱢᱟᱱ ᱴᱟᱠᱟ ᱵᱟᱡᱤ᱾ ᱯᱷᱨᱮᱧᱪ ᱨᱮ: ᱱᱣᱟᱨ᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ → and 1/37 for zeroᱪᱟᱠᱟᱡᱤᱨᱚᱢᱤᱫᱜᱮ ᱦᱟᱹᱨᱭᱟᱹᱲ ᱠᱷᱟᱱᱟ ᱡᱟᱦᱟᱸ ᱥᱚᱢᱟᱱ ᱴᱟᱠᱟ, ᱰᱚᱡᱮᱱ ᱟᱨᱵᱟᱝ ᱠᱚᱞᱚᱢ ᱵᱟᱡᱤ ᱵᱟᱭ ᱠᱚᱵᱷᱟᱨᱟ; ᱠᱮᱥᱤᱱᱳ ᱵᱟᱲᱛᱤ ᱨᱮᱭᱟᱜ ᱢᱩᱞ᱾ ᱮᱴᱟᱜ ᱧᱩᱛᱩᱢ: ᱥᱤᱝᱜᱚᱞ ᱡᱤᱨᱚ, 0᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ →. Red and black bets pay 1:1. Find their expected returns as percentages of the stake.
ᱥᱚᱢᱟᱫᱷᱟᱱ ᱩᱫᱩᱜ
ᱛᱮᱞᱟ ᱟᱨᱟᱜ ᱨᱮᱭᱟᱜ ᱠᱷᱚᱨᱚᱪ 18.9%; ᱦᱮᱸᱫᱮ 13.5% ᱮ ᱟᱹᱜᱩᱭᱟ᱾
ᱟᱨᱟᱜ 37 ᱨᱮ 15 ᱫᱷᱟᱣ ᱡᱤᱛᱟᱹᱣᱚᱜ-ᱟ ᱟᱨ 22 ᱦᱟᱨᱟᱣᱚᱜ-ᱟ: (15 − 22)/37 = −18.9%᱾ ᱦᱮᱸᱫᱮ 21 ᱫᱷᱟᱣ ᱡᱤᱛᱟᱹᱣᱚᱜ-ᱟ ᱟᱨ 16 ᱦᱟᱨᱟᱣᱚᱜ-ᱟ: (21 − 16)/37 = +13.5%᱾
ᱵᱟᱭᱟᱥ ᱫᱚ ᱵᱟᱨᱭᱟ ᱫᱷᱟᱨᱮ ᱮ ᱠᱟᱹᱢᱤᱭᱟ᱾ ᱡᱟᱦᱟᱸ ᱪᱟᱠᱟ ᱢᱟᱯ ᱟᱠᱟᱫ ᱠᱷᱮᱞᱚᱸᱰ ᱠᱮ ᱵᱟᱲᱛᱤ ᱮ ᱮᱢᱟ, ᱚᱱᱟ ᱜᱮ ᱵᱷᱩᱞ ᱨᱚᱝ ᱨᱮ ᱵᱟᱡᱤ ᱞᱟᱜᱟᱣ ᱠᱷᱮᱞᱚᱸᱰ ᱠᱷᱚᱱ ᱥᱟᱫᱷᱟᱨᱚᱬ ᱜᱚᱱᱚᱝ ᱨᱮᱭᱟᱜ ᱮᱭᱟᱭ ᱫᱷᱟᱣ ᱮ ᱤᱫᱤᱭᱟ᱾ ᱦᱩᱱᱟᱪᱮᱠ (Hunacek, 2025) ᱱᱚᱣᱟ ᱞᱮᱠᱟᱱ ᱫᱟᱹᱭᱠᱟᱹ ᱮ ᱵᱮᱵᱷᱟᱨ ᱟᱠᱟᱫᱟ᱾
37 ᱨᱮ ᱯᱮ ᱠᱷᱟᱱᱟ ᱫᱚ ᱟᱹᱰᱤ ᱢᱟᱨᱟᱝ ᱠᱷᱟᱹᱢᱤ ᱠᱟᱱᱟ᱾ ᱥᱟᱹᱨᱤ ᱵᱟᱭᱟᱥ ᱫᱚ ᱟᱭᱢᱟ ᱫᱷᱟᱣ ᱱᱚᱣᱟ ᱨᱮᱭᱟᱜ ᱦᱩᱰᱤᱧ ᱦᱟᱹᱴᱤᱧ ᱜᱮ, ᱟᱨ ᱵᱷᱟᱜᱽ ᱠᱷᱚᱱ ᱚᱱᱟ ᱵᱷᱤᱱ ᱞᱟᱹᱜᱤᱫ ᱦᱟᱡᱟᱨ ᱦᱟᱡᱟᱨ ᱜᱷᱩᱨᱟᱹᱣ ᱞᱟᱹᱠᱛᱤᱭᱟ, ᱱᱚᱣᱟ ᱥᱟᱦᱴᱟ ᱡᱮᱞᱠᱟ ᱩᱫᱩᱜᱟ᱾
ᱞᱟᱸᱫᱟ ᱞᱟᱹᱜᱤᱫ ᱠᱚᱢᱤᱠ
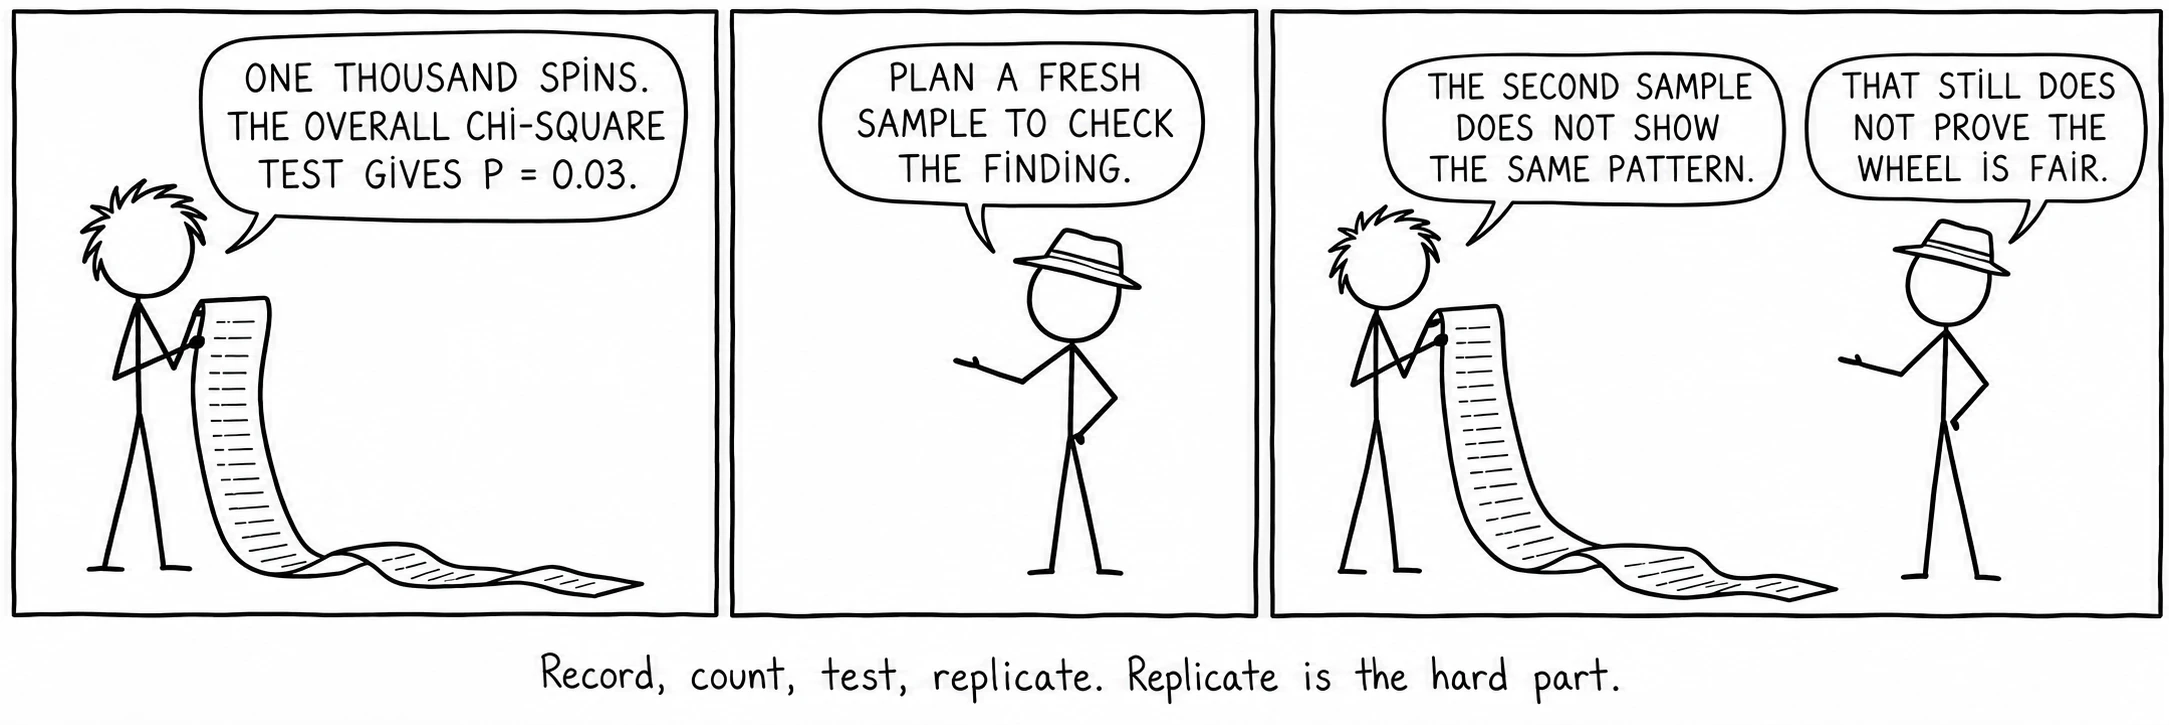
ᱚᱞ, ᱞᱮᱠᱷᱟ, ᱯᱚᱨᱚᱠᱷ, ᱫᱚᱦᱲᱟ ᱠᱚᱨᱟᱣ᱾ ᱫᱚᱦᱲᱟ ᱠᱚᱨᱟᱣ ᱜᱮ ᱫᱩᱨᱩᱵ ᱦᱤᱥᱟᱹ ᱠᱟᱱᱟ᱾
ᱯᱷᱮᱰᱟᱛ
- Pearson, K. “On the criterion that a given system of deviations from the probable…”
- Barnhart, R. T. Beating the Wheel.