ᱱᱢᱩᱱᱟ ᱢᱟᱯ
ᱢᱤᱫ ᱫᱷᱟᱡᱽ ᱨᱮᱭᱟᱜ ᱢᱟᱱᱮ ᱧᱟᱢ ᱞᱟᱹᱜᱤᱫ ᱛᱤᱱᱟᱹᱜ ᱜᱷᱩᱨᱟᱹᱣ ᱞᱟᱹᱠᱛᱤ᱾
ᱢᱤᱫ ᱠᱷᱟᱱᱟ 37 ᱠᱷᱚᱱ 1 ᱵᱚᱫᱚᱞ ᱨᱮ 30 ᱠᱷᱚᱱ 1 ᱫᱷᱟᱣ ᱦᱩᱭᱩᱜ ᱠᱟᱱᱟ, ᱱᱚᱶᱟ ᱵᱤᱥᱣᱟᱥ ᱥᱟᱶ ᱧᱟᱢ ᱞᱟᱹᱜᱤᱫ ᱯᱟᱥᱤ 4,400 ᱜᱷᱩᱨᱟᱹᱣ ᱞᱟᱹᱠᱛᱤᱭᱟ᱾ 35 ᱠᱷᱚᱱ 1 ᱨᱮᱭᱟᱜ ᱠᱷᱟᱱᱟ, ᱡᱟᱦᱟᱸ ᱥᱟᱹᱨᱤ ᱛᱮ ᱞᱟᱵᱷ ᱮᱢ ᱫᱟᱲᱮᱭᱟᱜ-ᱟ, ᱚᱱᱟ ᱞᱟᱹᱜᱤᱫ ᱯᱟᱥᱤ 70,000 ᱜᱷᱩᱨᱟᱹᱣ ᱞᱟᱹᱠᱛᱤᱭᱟ᱾
ᱪᱮᱫᱟᱜ ᱱᱚᱣᱟ ᱟᱭᱢᱟ
For n independent spinsᱜᱚᱱᱤᱛᱟᱡᱟᱫ ᱜᱷᱩᱨᱟᱹᱣᱢᱟᱨᱮ ᱪᱮᱫ ᱦᱚᱸ ᱦᱩᱭ ᱠᱷᱟᱱ ᱦᱚᱸ ᱡᱚᱛᱚ ᱜᱷᱩᱨᱟᱹᱣ ᱨᱮ ᱥᱚᱢᱵᱷᱟᱵᱱᱟ ᱢᱤᱫ ᱞᱮᱠᱟ ᱜᱮ᱾ ᱱᱚᱶᱟ ᱥᱟᱭᱤᱴ ᱨᱮᱭᱟᱜ ᱡᱚᱛᱚ ᱦᱤᱥᱟᱹᱵ ᱨᱮᱭᱟᱜ ᱵᱮᱥ᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ →, the hit count has standard deviationᱜᱚᱱᱤᱛᱥᱴᱮᱱᱰᱟᱨᱰ ᱰᱤᱵᱷᱤᱭᱮᱥᱚᱱᱣᱮᱨᱤᱭᱮᱱᱥ ᱨᱮᱭᱟᱜ ᱵᱚᱜᱚ ᱢᱩᱞ; ᱟᱸᱫᱟᱡᱽ ᱜᱚᱱᱚᱝ ᱠᱷᱚᱱ ᱨᱮᱡᱟᱞᱴ ᱨᱮᱭᱟᱜ ᱥᱟᱫᱷᱟᱨᱚᱱ ᱥᱟᱦᱟ᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ → √(np(1−p)); the estimated hit rate has standard error √(p(1−p)/n). Counts get noisier in absolute terms as n grows, while the uncertainty in the rate shrinks. Halving that rate uncertainty requires about four times as many spins.
ᱯᱷᱚᱨᱢᱩᱞᱟ
For a one-sided test of a single pocketᱥᱟᱡ ᱥᱟᱢᱟᱱᱠᱷᱟᱱᱟᱨᱚᱴᱚᱨ ᱨᱮᱭᱟᱜ 37 ᱮᱞ ᱚᱞ ᱠᱷᱟᱱᱟ ᱠᱷᱚᱱ ᱢᱤᱫ᱾ ᱮᱴᱟᱜ ᱧᱩᱛᱩᱢ: ᱥᱞᱚᱴ, ᱠᱟᱯ᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ → at the 5% level with 80% power, the required n is approximately ((1.645·√(p₀(1−p₀)) + 0.84·√(p₁(1−p₁))) / (p₁ − p₀))², with p₀ = 1/37 and p₁ the suspected rate. That holds for one pocket chosen in advance. Searching all 37 pockets requires a multiple-testing design; there is no universal sample-size multiplier. This tests departure from 1/37, not a profitable rate above 1/36.
ᱠᱟᱹᱢᱤ ᱨᱮᱭᱟᱜ ᱯᱟᱲᱦᱟᱣ
Sample size alone does not make an observation evidence or noise. Specify the effect, test and error rates before collecting data. A small sample can identify an extreme failure, while even a large sample may miss a very small departure. Replication and reliable recording remain necessary.
ᱰᱟᱴᱟ ᱨᱮᱭᱟᱜ ᱜᱚᱱᱚᱝ
At 50 spins an hour, recording 10,000 rounds takes 200 hours. Equipment changes during that time can complicate interpretation. That practical constraint does not establish that all bias detection is impossible or that every historical investigation took months.
ᱠᱮᱥᱤᱱᱳ ᱵᱟᱲᱛᱤ ᱞᱟᱹᱜᱤᱫ ᱱᱢᱩᱱᱟ ᱢᱟᱯ
For a unitᱴᱟᱠᱟᱭᱩᱱᱤᱴᱢᱤᱫ ᱥᱤᱥᱴᱮᱢ ᱟᱨᱵᱟᱝ ᱠᱷᱮᱞᱚᱸᱰ ᱵᱮᱵᱷᱟᱨ ᱵᱮᱥ ᱵᱟᱡᱤ ᱴᱟᱠᱟ᱾ ᱯᱨᱚᱜᱽᱨᱮᱥᱚᱱ ᱠᱚ ᱭᱩᱱᱤᱴ ᱛᱮ ᱵᱩᱡᱷᱟᱹᱣᱚᱜ-ᱟ ᱡᱮᱢᱚᱱ ᱡᱟᱦᱟᱸᱱ ᱴᱮᱵᱩᱞ ᱨᱮ ᱞᱟᱹᱜᱩ ᱦᱩᱭᱩᱜ-ᱟ᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ → even-money single-zeroᱪᱟᱠᱟᱡᱤᱨᱚᱢᱤᱫᱜᱮ ᱦᱟᱹᱨᱭᱟᱹᱲ ᱠᱷᱟᱱᱟ ᱡᱟᱦᱟᱸ ᱥᱚᱢᱟᱱ ᱴᱟᱠᱟ, ᱰᱚᱡᱮᱱ ᱟᱨᱵᱟᱝ ᱠᱚᱞᱚᱢ ᱵᱟᱡᱤ ᱵᱟᱭ ᱠᱚᱵᱷᱟᱨᱟ; ᱠᱮᱥᱤᱱᱳ ᱵᱟᱲᱛᱤ ᱨᱮᱭᱟᱜ ᱢᱩᱞ᱾ ᱮᱴᱟᱜ ᱧᱩᱛᱩᱢ: ᱥᱤᱝᱜᱚᱞ ᱡᱤᱨᱚ, 0᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ → bet, the mean is −1/37 and the standard deviation is √(1368)/37. After 1,368 independent bets, expected lossᱜᱚᱱᱤᱛᱟᱸᱫᱟᱡᱽ ᱦᱟᱹᱱᱤᱟᱸᱫᱟᱡᱽ ᱜᱚᱱᱚᱝ ᱜᱩᱬ ᱡᱚᱛᱚ ᱵᱟᱡᱤ ᱴᱟᱠᱟ; ᱢᱤᱫ ᱥᱮᱥᱚᱱ ᱟᱨᱵᱟᱝ ᱚᱠᱛᱚ ᱨᱮ ᱟᱣᱥᱚᱛ ᱛᱮ ᱦᱟᱨᱟᱣᱚᱜ ᱴᱟᱠᱟ᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ → is one standard deviation of the total. At 10,000 it is about 2.70 standard deviations. Neither threshold guarantees a losing result or validates a system.
ᱯᱷᱚᱨᱢᱩᱞᱟ
ᱠᱩᱠᱞᱤ ᱠᱚ
No. Grouping helps only when the alternative concentrates enough extra probabilityᱜᱚᱱᱤᱛᱥᱚᱢᱵᱷᱟᱵᱱᱟᱢᱤᱫ ᱨᱮᱡᱟᱞᱴ ᱨᱮᱭᱟᱜ ᱥᱚᱢᱵᱷᱟᱵᱱᱟ, 0 ᱠᱷᱚᱱ 1 ᱟᱨᱵᱟᱝ 0% ᱠᱷᱚᱱ 100%᱾ ᱢᱤᱫ ᱮᱞ: 1/37 = 2.70%᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ → in that sectorᱪᱟᱠᱟᱥᱮᱠᱴᱚᱨᱪᱟᱠᱟ ᱨᱮ ᱛᱟᱭᱚᱢ ᱛᱟᱭᱚᱢ ᱠᱷᱟᱱᱟ ᱨᱮᱭᱟᱜ ᱢᱤᱫ ᱜᱩᱞᱟᱹᱭ ᱦᱟᱹᱴᱤᱧ, ᱞᱮᱭᱟᱣᱴ ᱨᱮᱭᱟᱜ ᱜᱩᱴᱤ ᱠᱷᱚᱱ ᱟᱞᱟᱜ᱾ᱯᱩᱨᱟᱹ ᱯᱟᱲᱦᱟᱣ →. It can dilute a localized pocket effect.
ᱦᱮᱸ, ᱡᱩᱫᱤ ᱪᱟᱠᱟ ᱵᱚᱦᱚᱜ ᱚᱱᱟ ᱜᱮ ᱠᱟᱱᱟ ᱟᱨ ᱥᱟᱨᱣᱤᱥ ᱵᱟᱝ ᱦᱩᱭ ᱟᱠᱟᱱᱟ᱾ ᱱᱚᱣᱟ ᱵᱟᱰᱟᱭ ᱜᱮ ᱠᱷᱟᱹᱞᱤ ᱢᱩᱥᱠᱤᱞ᱾
ᱪᱟᱞᱟᱜ ᱞᱮᱠᱟ᱾ ᱱᱚᱣᱟ ᱨᱮᱭᱟᱜ ᱢᱟᱱᱮ ᱫᱚ ᱞᱟᱹᱭ ᱟᱠᱟᱱ ᱢᱟᱯ ᱨᱮᱭᱟᱜ ᱢᱤᱫ ᱥᱟᱹᱨᱤ ᱵᱟᱭᱟᱥ ᱫᱚ ᱢᱚᱬᱮ ᱫᱷᱟᱣ ᱠᱷᱚᱱ ᱯᱩᱱ ᱫᱷᱟᱣ ᱧᱟᱢᱚᱜ-ᱟ᱾
ᱞᱟᱸᱫᱟ ᱞᱟᱹᱜᱤᱫ ᱠᱚᱢᱤᱠ
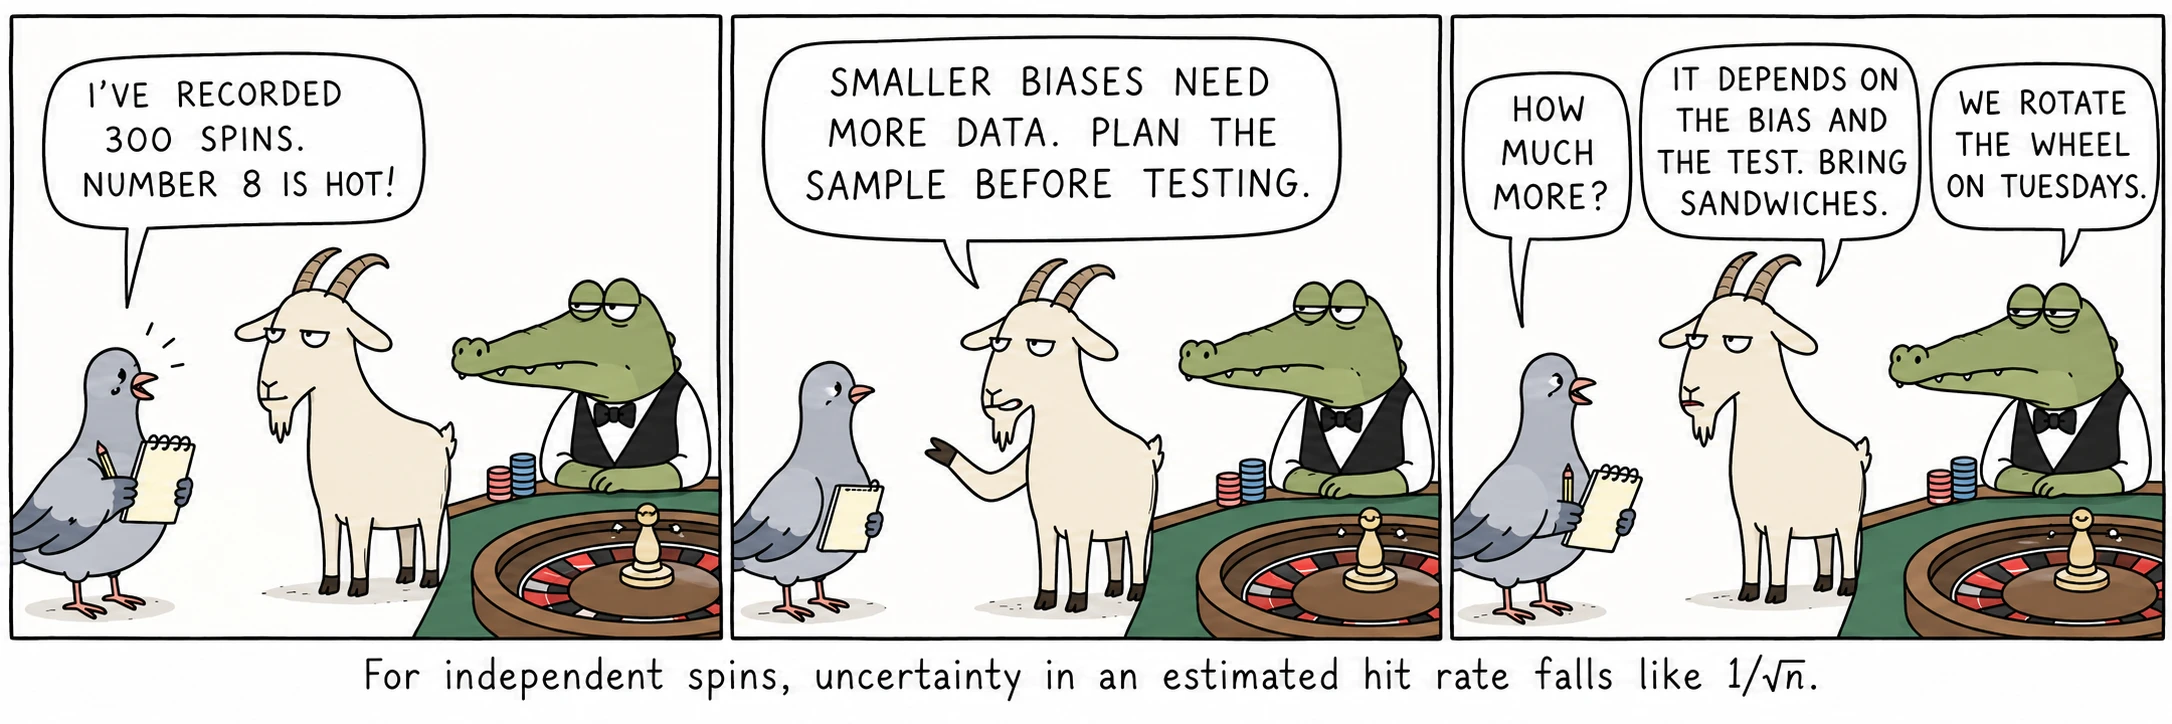
ᱦᱩᱞᱟᱹᱢ 1/√n ᱞᱮᱠᱟ ᱠᱚᱢᱚᱜ-ᱟ᱾ ᱥᱚᱵᱚᱨ ᱫᱚ ᱟᱨᱦᱚᱸ ᱞᱚᱜᱚᱱ ᱠᱚᱢᱚᱜ-ᱟ᱾
ᱯᱷᱮᱰᱟᱛ
- Feller, W. An Introduction to Probability Theory and Its Applications, Vol. 1.
- Barnhart, R. T. Beating the Wheel.
- ᱱᱢᱩᱱᱟ ᱢᱟᱯ ᱦᱤᱥᱟᱹᱵ